全角とは?半角との違い・見分け方とPCスマホの変換術を徹底解説
Webフォームで会員登録や決済を進めている最中、「全角で入力してください」「半角数字のみ有効です」というエラーメッセージに直面し、作業を中断させられた経験は誰にでもあるはずです。見た目にはわずかな隙間や幅の違いに過ぎないように思える文字が、なぜデジタル空間では明確に区別され、時に重大なシステムエラーを引き起こすのでしょうか。
日本語の入力環境において日常的に使われる「全角」と「半角」ですが、その背景には活版印刷の時代からコンピューター黎明期を経て受け継がれてきた技術的な歴史と、文字コード(バイト数)の構造が存在します。本記事では、全角の定義や半角との決定的な見分け方、パソコンやスマートフォンでの高速変換テクニック、そしてWeb入力トラブルを未然に防ぐための実践知識を徹底的に解き明かします。
📌 【この記事の重要ポイントまとめ】
- 要点1:全角とは正方形(1:1)の枠内に収まる文字規格であり、半角はその半分の幅(1:2)を持つ文字を指す。
- 要点2:エラーの根底には文字コードの「バイト数」とデータベース設計があり、特に全角数字や全角スペースの混入が不具合の主因となる。
- 要点3:PCのファンクションキー(F7〜F10)やスマホの入力設定を最適化することで、日々の変換ストレスは劇的に軽減できる。
【基礎から解明】全角とは何か?半角との決定的な違いと見分け方
全角(ぜんかく)とは、文字を表示する領域の縦横比が「1対1の正方形」で作られている文字の総称です。原稿用紙の1マスに1文字が収まる形状をイメージすると直感的に理解できます。日本語の漢字、ひらがな、全角カタカナは基本的にすべて全角の規格で作られており、これに加えて正方形の幅に合わせてデザインされた「全角英数」や各種記号が存在します。
一方の半角(はんかく)は、全角のちょうど半分、すなわち「横幅が縦の約2分の1(比率1:2)」の縦長な枠に収まる文字を指します。アルファベットや数字はもともと欧米のタイプライターや印刷技術を基礎としているため、文字ごとに幅が異なるプロポーショナルフォントか、あるいは等幅の半角を標準として発展してきました。
視覚とデータで見分ける「全角文字一覧」
画面上で文字が全角か半角かを見分ける基準は、主に「文字幅」と「フォントの配置バランス」にあります。日常で頻繁に扱われる代表的な文字種の区分は以下の通りです。
- 全角文字一覧(代表例):
- 漢字・ひらがな(あ、い、漢、字 ※これらに半角規格は基本的に存在しません)
- 全角カタカナ(ア、イ、ウ、エ、オ)
- 全角英数字(A、B、C、1、2、3)
- 全角記号・スペース(!、?、@、:、 ←全角空白)
- 半角文字一覧(代表例):
- 半角英数字(A, B, C, 1, 2, 3)
- 半角記号(!, ?, @, :, ←半角空白)
- 半角カタカナ(ア, イ, ウ, エ, オ)
最も見落としやすい「全角スペースの見分け方」
実務で最もトラブルを引き起こしやすいのが「全角スペース(空白文字)」です。文字が描画されないため、一見すると半角スペースとの区別がつきません。これを見分けるには以下の方法が確実です。
テキストエディタ(VS CodeやNotepad++など)やWordでは、設定により空白文字を可視化できます。Wordの場合は上部メニューの「ホーム」タブにある「編集記号の表示/非表示(¶)」をオンにすると、全角スペースは「四角い枠(□)」、半角スペースは「小さな黒点(・)」として画面上に表示されます。また、ブラウザの入力欄であれば、空白部分をマウスでドラッグして選択した際、選択範囲の横幅が文字1文字分あれば全角、その半分なら半角と判別できます。

【徹底比較】全角と半角の仕様・バイト数・役割の違い
全角と半角の本質的な違いは、画面上の見た目だけでなく、コンピューター内部で文字を処理する際の「データサイズ(バイト数)」にあります。ITシステムやデータベースが両者を厳格に区別するのは、このメモリ構造が根本から異なるためです。
| 項目 | 全角文字(Full-width) | 半角文字(Half-width) | 編集部の見解・評価 |
|---|---|---|---|
| 文字幅の比率 | 1 : 1(正方形) | 1 : 0.5(縦長・半分の幅) | 和文の可読性には全角、英文や数値列には半角が最適。 |
| データ容量(Shift_JIS) | 2バイト(16ビット) | 1バイト(8ビット) | 過去のシステムが「2バイト文字」と呼んでいた名残。 |
| データ容量(UTF-8) | 3バイト(一部4バイト) | 1バイト(半角カナは3バイト) | 国際標準規格では文字種により可変長処理される。 |
| 主な構成文字 | 漢字、ひらがな、カタカナ、全角英数 | 半角英数、半角記号、半角カナ | 半角カナは表示崩れの原因になりやすいため注意が必要。 |
| 国際的な英語表現 | Full-width / Double-byte | Half-width / Single-byte | 海外製ソフトウェアのUIでは「Full-width」が標準。 |
かつて主流だった文字コード規格「Shift_JIS」では、半角文字を「1バイト(8ビット=256通りの表現)」で管理し、膨大な文字数を持つ日本語の全角文字を「2バイト(16ビット=約6万5千通りの表現)」で管理していました。この名残から、日本のIT現場では全角文字を「2バイト文字(ダブルバイト文字)」、半角文字を「1バイト文字(シングルバイト文字)」と呼ぶ慣習が定着しました。
現在標準となっている「UTF-8」においては、半角英数は1バイトですが、全角のひらがなや漢字、全角英数は基本的に3バイト(絵文字や一部の希少漢字は4バイト)を消費します。全角文字は半角英数に比べてデータ通信量や保存容量を多く消費する構造になっています。
【歴史と背景】なぜ2つの規格が存在するのか?活版印刷からデジタルへの系譜
全角という言葉の由来は、コンピューターが誕生するはるか前、明治期に確立された活版印刷技術にさかのぼります。印刷業界では、正方形の活字ボディ(鋳型)そのものを「全角(エム / em)」と呼び、その半分を「半角(エン / en)」と呼んでいました。日本語の文章は正方形のマス目の中に均等に文字を並べることで美しさを保つ組版ルールを持っていたため、全角が基本単位となったのです。
1960〜1970年代にコンピューターが日本に導入された際、初期のマシンはメモリ容量が極めて乏しく、英数字と同じ1バイト(半角)でしか文字を扱えませんでした。そこで編み出されたのが、限られた文字数で日本語のニュアンスを伝えるための「半角カタカナ(JIS X 0201規格)」です。初期の金融機関の通帳印字や電報システムで半角カタカナが多用されたのは、ハードウェアの制約による必然でした。
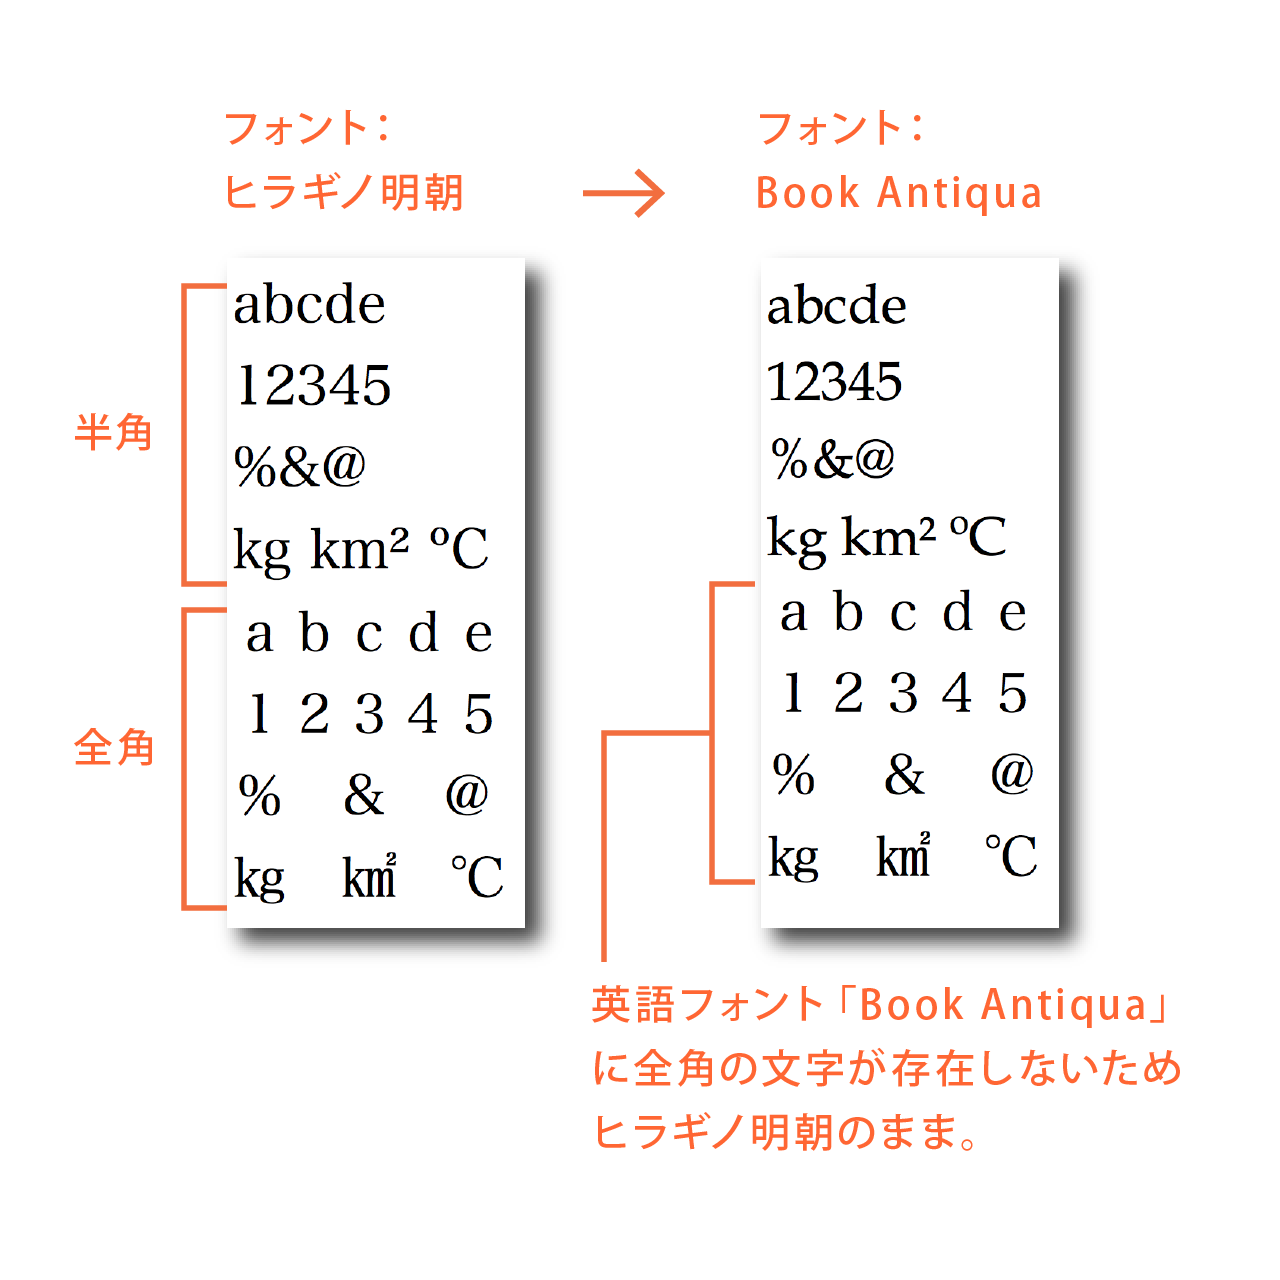
1978年に制定された「JIS C 6226(後のJIS X 0208)」により、漢字やひらがなを含む約6,800文字の2バイト規格(全角)が本格的に実用化されました。このとき、既存の欧米製ソフトウェアとの互換性や文字並びの美観を整える目的で、半角英数字とは別に「正方形の幅を持った全角英数字・全角記号」が新たに追加されました。これが、現在まで続く「同じアルファベットや数字に全角と半角の2種類が併存する」という独特なデジタル環境の起源です。
【実態検証】なぜ「全角数字」でエラーが出るのか?Webフォーム現場のリアル
多くのユーザーが直面する疑問が、「なぜ電話番号や郵便番号、クレジットカード番号の入力で全角数字が拒否されるのか」という問題です。人間が見れば「123」も「123」も同じ意味として認識できますが、システム内部では全く異なる文字データとして扱われます。
システム開発の現場取材やITエンジニアの証言によると、全角数字がエラーを引き起こす主な理由は以下の3点に集約されます。
- データベースの型不一致(数値型と文字列型): システムが数値を計算したりソートしたりする場合、データベースの項目を「数値型(INTEGERなど)」として定義します。半角数字は直接数値として格納できますが、全角数字はシステムから見ると「日本語の文字列」として判定されるため、データ型エラーが発生して処理が停止します。
- セキュリティと外部API連携の制約: クレジットカード決済の代行ゲートウェイや銀行のAPIは、国際規格に準拠した「半角数字のみ」を受け付ける仕様が一般的です。もし全角数字がそのまま送信されると、決済処理側で構文エラー(Syntax Error)となり、決済そのものが失敗してしまいます。
- バリデーション(入力検証)の厳格さ: セキュリティ対策として、悪意あるコードの注入(SQLインジェクションなど)を防ぐため、入力欄に半角数字以外が混ざった瞬間に処理を遮断する厳格な正規表現チェックが設定されているケースがあります。
現代の洗練されたWebサイトでは、ユーザーが誤って全角数字を入力しても、送信時にJavaScriptやバックエンド処理で自動的に半角へ正規化(UnicodeのNFKC正規化など)する仕組みが標準化されつつあります。しかし、官公庁のポータルサイトや数十年前から稼働し続けている金融系レガシーシステムでは、この自動変換が実装されておらず、ユーザーに手動での半角入力を強いるケースが残存しています。
【作業効率化】一瞬で切り替える全角半角変換ショートカットと入力テクニック
文字入力中の変換ミスや、意図しない全角・半角の混在は、ショートカットキーとデバイスの設定を把握しておくことで瞬時に修正できます。
Windows環境のファンクションキー活用法
Windowsの日本語IMEでは、文字を入力して変換キーを押す前(下線が表示されている状態)に、キーボード最上段のファンクションキーを押すことで、一発で文字種を変換できます。
- F6キー:すべて「全角ひらがな」に変換(例: テスト → てすと)
- F7キー:すべて「全角カタカナ」に変換(例: てすと → テスト)
- F8キー:すべて「半角カタカナ」に変換(例: テスト → テスト)
- F9キー:すべて「全角英数」に変換(1回押すと小文字、2回で大文字、3回で頭文字のみ大文字)
- F10キー:すべて「半角英数」に変換(入力中の「test」を「test」に一撃で変換)
英単語を入力したつもりが全角の「test」になってしまった場合、確定前にF10キーを押すだけで半角英数に切り替わります。また、WordやExcel上で確定してしまった文字を一括変換したい場合は、文字列を選択した状態で「Shift + F3」を押すか、ホームタブの「文字種の変換」機能を利用します。
Mac環境での効率的な変換ショートカット
Macの標準日本語入力(日本語IM)では、以下のキーコンビネーションが割り当てられています。
- Control + J:全角ひらがなに変換
- Control + K:全角カタカナに変換
- Control + ;(セミコロン):半角カタカナに変換
- Control + L:全角英数に変換
- Control + :(コロン):半角英数に変換
スマホ(iPhone / Android)での全角・半角入力トラブル回避策
スマートフォンでの文字入力では、「半角カタカナが打てない」「数字が勝手に全角になってしまう」というトラブルが頻発します。
iPhone(iOS標準キーボード)では、数字キーパッドから入力すると通常は半角になりますが、日本語かな入力の状態で数字を入力すると全角が優先候補に表示される仕様です。半角カタカナを入力したい場合、標準の予測変換候補の末尾までスクロールして「半角」と書かれた候補を選択するか、他社製キーボードアプリ(Gboardなど)を利用して明示的に半角を指定します。
Android(Gboard環境)では、キーボード設定の「詳細設定」から「数字を常に半角で入力」を有効に設定しておくことで、日本語入力中であってもテンキーからの数字入力が自動的に半角へと固定され、入力エラーの発生を根本から防ぐことができます。

【プロの結論】デジタルリテラシーから見る「文字種統一」の判断基準
全角と半角が混在するテキストは、視覚的な美観を損なうだけでなく、検索性の低下やプログラムの予期せぬ不具合を招く要因となります。実務において迷った際の判断基準は、国際標準のタイポグラフィ原則と日本語の組版ルールの組み合わせによって決定づけられます。
【実践ガイド】全角と半角の最適な使い分け基準
- 半角を原則とすべき場面:
- URL、メールアドレス、プログラミングコード、HTMLタグ
- 電話番号、郵便番号、金額、日付などの数値データ全般
- データベースの検索キーワード入力、フォームのID・パスワード欄
- 全角を原則とすべき場面:
- 日本語の文章内における漢字、ひらがな、全角カタカナ
- 公用文や文芸作品における句読点(、。)や括弧(「」)
- デザイン上の意図として、日本語の文字並びと均等な正方形のグリッドを保ちたい見出しの装飾
- 原則として使用を避けるべき文字:
- 半角カタカナ:古いメールソフトや特定のブラウザで文字化け(文字コードの誤認)を起こしやすく、アクセシビリティ(音声読み上げソフト)での誤読リスクが高いため、電子データでの使用は推奨されません。
- 全角スペースの単独混入:ソースコードや数式、データ列に誤って全角スペースが混入すると、エラー箇所の特定が極めて困難になるため厳禁です。
文章の可読性を高めるテクニックとして、日本語(全角)とアルファベット・数字(半角)が隣接する際、その間に「半角スペースを1つ挟む」または「CSSのletter-spacingで微細な余白を持たせる」という手法がWebメディア業界で広く採用されています。文字種ごとの特性を理解し、ルールを一定に保つことこそが、情報伝達の正確性と作業効率を最大化させる鍵です。
【全角とは】に関するよくある質問(FAQ)
Q1:全角英数字はなぜ作られたのですか?使うメリットはあるのでしょうか?
A1:活版印刷以来の「日本語は正方形のマス目に並べる」という美意識に基づき、縦書きの文章や等幅表示の原稿用紙で英数字が不自然に縮んで見えないようにするために作られました。縦書きの書籍や一部のポスター見出しなど、日本語の文字幅とバランスを揃えたい特定のデザイン用途以外では、データの互換性を重視して半角英数字を使うのが現代の標準です。
Q2:全角カタカナと半角カタカナはどうやって相互変換しますか?
A2:パソコンであれば、文字入力時にF7(全角カナ)またはF8(半角カナ)を押すことで即座に切り替えられます。既存の文章を一括変換したい場合は、Excelの「=JIS(セル)」関数(半角を全角に変換)や「=ASC(セル)」関数(全角を半角に変換)を活用するのが最も効率的です。
Q3:英語圏の人に「全角」「半角」を説明するときは何と言えば通じますか?
A3:英語では、全角を「Full-width characters(フルワイド・キャラクターズ)」、半角を「Half-width characters(ハーフワイド・キャラクターズ)」と表現します。また、文字コードのデータ構造を説明する技術的な文脈では、「Double-byte(ダブルバイト)」および「Single-byte(シングルバイト)」と説明すると正確に伝わります。
Q4:プログラミングのコード中に全角スペースが入るとエラーになるのはなぜですか?
A4:プログラミング言語のコンパイラやインタープリタは、構文の区切り文字として「半角スペース(ASCIIコード 0x20)」のみを認識するように設計されているためです。全角スペース(Unicode U+3000など)がコード内に混ざると、システムはそれを「未定義の不正な文字」と認識し、構文エラー(Syntax Error)を吐き出して実行を停止させます。
まとめ:全角の仕組みを理解して入力トラブルを完全に防ごう
全角とは、日本語の組版文化を尊重して作られた「正方形の文字規格」であり、データ構造上も半角文字とは根本的に異なる存在です。Webフォームでのエラーや文字化けといったトラブルは、コンピューターが文字を「意味」ではなく「バイト数と文字コード」で処理しているという仕組みから生じています。
日常の作業において、「英数字や記号、スペースは半角」「日本語のテキストは全角」という原則を意識し、ショートカットキー(F7〜F10)や可視化ツールを適切に使いこなすことで、入力のストレスや予期せぬデータ不具合を完全に排除できます。文字規格の背景にある論理を理解し、よりスマートで正確なデジタルコミュニケーションを実践していきましょう。 (出典: 全角 と は(Yahoo!ニュース))
SEOライティングとマーケティング戦略の専門家。分かりやすい解説記事で定評があります。
