消えたページを復元!ウェイバックマシンの使い方と見れない理由解説
突然アクセスできなくなったブログ、リニューアルで消去された公式発表、あるいは過去のニュース記事など、Web上の情報はある日予告なしに姿を消してしまうケースが後を絶ちません。「あのとき書かれていた正確なテキストを確認したい」「消えたサイトのレイアウトを復元したい」という需要は、リサーチやビジネス、学術調査の現場で年々高まっています。
そうした場面で世界中のユーザーに重宝されているのが、過去のWebページをタイムマシンのように遡って閲覧できるサービス「ウェイバックマシン(Wayback Machine)」です。本稿では、基本操作から最新のURL保存機能、さらには「なぜかアーカイブが表示されない」といったトラブルの決定的な要因や裏技まで、IT専門記者の視点から分かりやすく解説します。
📌 【この記事の重要ポイントまとめ】
- 要点1:ウェイバックマシンを使えば、URLを入力するだけで過去に記録されたWebページの履歴を誰でも無料で閲覧可能。
- 要点2:ページが見れない主な理由は「robots.txtの設定」「JavaScript依存の動的ページ」「権利者による削除申請」にある。
- 要点3:今あるページを将来に残す「手動保存(Save Page Now)」や、国内の「Web魚拓」との特性の違いを理解することが不可欠。
【基本概要】インターネットアーカイブが運営する「ウェイバックマシン」とは?
ウェイバックマシンは、米サンフランシスコに本拠を置く非営利団体インターネットアーカイブ(Internet Archive)が1996年から提供している巨大なデジタルアーカイブシステムです。同団体は「人類のあらゆる知識へのユニバーサルアクセス」を掲げており、Webページだけでなく電子書籍、音声、映像、ソフトウェアなどを日々収集・保存し続けています。
全世界を巡回する自動クローラーによって、数千億ページ規模のデータが定期的にスナップショットとして蓄積されています。インターフェース自体は英語ベースですが、ブラウザの翻訳機能を使わずとも直感的に扱える仕様となっており、実質的にWayback Machineは日本語環境でも何不自由なく利用できます。
単なる過去ログの閲覧にとどまらず、企業の沿革調査、デザインの変遷確認、さらにはネット上の発言撤回や不祥事における一次情報の検証など、現代の情報社会におけるデジタルな公文書館としての役割を果たしています。
【実践手順】過去のサイトを見る方法と削除されたページの確認手順
アクセス不能になったWebページや、過去の特定日時の状態を確認する手順は極めてシンプルです。特別なツールをインストールする必要はなく、標準的なブラウザから即座に実行できます。
具体的な過去のサイトを見る方法は以下の3ステップです。
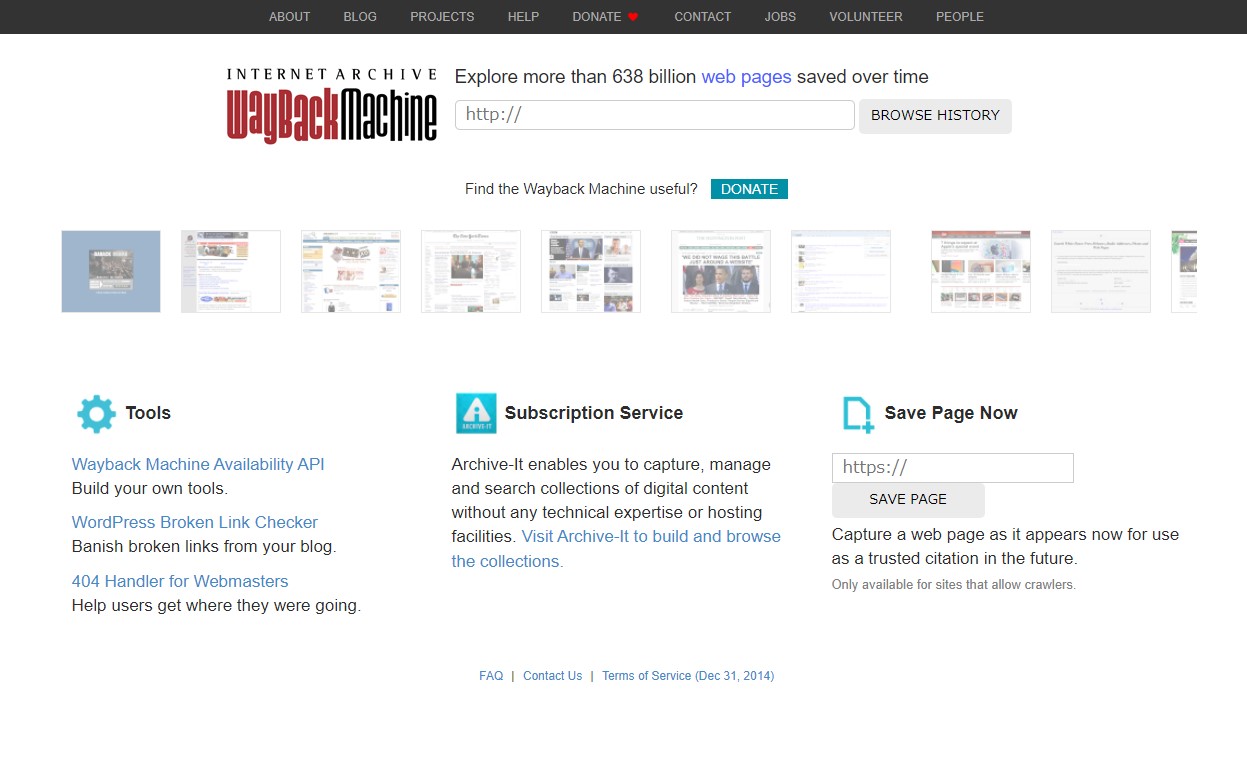
1. ウェイバックマシンの公式サイト(web.archive.org)にアクセスする。
2. 検索バーに確認したいページの完全なURL(例:https://example.com/page)を入力してEnterキーを押す。
3. 画面上に表示される年表バーから確認したい「西暦年」を選び、下に表示されるカレンダー上の青または緑の丸で囲まれた日付をクリックし、ポップアップ内のタイムスタンプを選択する。
カレンダーに表示される丸の色には意味があり、青色は正常に保存されたスナップショット(HTTP 200)、緑色はリダイレクト(HTTP 3xx)を示しています。過去ログ検索を行う際は、できるだけ青色のマークがついた日時を選ぶのが、消えたサイトの確認方法として最も確実です。
【決定版】今あるWebページを残す!手動でのURL保存方法と最新機能
「この有益な記事が消える前に残しておきたい」「証拠として現在の状態を魚拓のように保存したい」という場合は、クローラーの巡回を待たずに手動で即時保存することが可能です。
トップページ右下に配置されている「Save Page Now」という入力欄にURLをペーストし、「SAVE PAGE」をクリックするだけで、その瞬間のスナップショットがインターネットアーカイブのサーバーに恒久的に記録されます。これが標準的なURL保存方法です。
保存時には、以下のような拡張オプションも選択できます。
・アウトバウンドリンクの保存:ページ内に含まれる外部リンク先も同時にアーカイブする。
・スクリーンショットの同時記録:見たままのレイアウトを画像として保存し、デザイン崩れを防ぐ。
・アカウント連携による履歴管理:無料のユーザー登録を行えば、自身が保存したURLのリストを一括管理・エクスポートできる。
後々の削除されたページの復元や資料引用を想定している場合、記事が公開された直後のタイミングで手動保存を実行しておくことが確固たる防衛策になります。
「Web魚拓」との決定的な違いは?用途別の使い分けとメリット比較
日本国内で過去のWebページ保存といえば、株式会社アフィリティーが運営する「Web魚拓」も広く知られています。両者は一見似ていますが、その設計思想とシステムには明確な違いがあります。
最大の違いはデータの収集手法です。ウェイバックマシンは世界中をボットが自動巡回して網羅的に記録する「巨大図書館型」であるのに対し、Web魚拓はユーザーが指定したURLのみをその場で静的キャプチャする「オンデマンド型」です。
また、ウェイバックマシンはページ内のリンク構造を保持するため、過去のサイト内を擬似的に回遊(別ページへクリック移動)できる強みを持っています。一方、Web魚拓は日本語の動的コンテンツや掲示板のスレッド単体を素早く静止画・テキストとして確定保存する点に長けています。
ブログ全体やコーポレートサイトの変遷を体系的に追いたい場合はウェイバックマシン、炎上投稿や一時的な告発ページをピンポイントで保全したい場合はWeb魚拓、といった用途別の使い分けが有効です。
なぜ?ウェイバックマシンで見れない・エラーが出る4大理由
「URLを入れたのに『Hrm. Way Back Machine has not archived that URL.』と出て何も表示されない」「過去の日付をクリックしても真っ白な画面になる」といったトラブルに直面することがあります。ウェイバックマシンで見れない理由には、主に以下の4つの原因が存在します。
1. robots.txtによる収集拒絶
Webサイトの管理者がサーバー上に配置する検索制御ファイル「robots.txt」にて、インターネットアーカイブのクローラー(ia_archiver)をブロックするrobots.txt除外設定を行っている場合、スナップショット自体が収集されません。
2. 高度なJavaScriptや動的ローディング
最新のWeb技術(SPA:シングルページアプリケーションなど)で構築されたサイトや、スクロールしないと読み込まれないコンテンツ、ログイン必須のページは、アーカイブサーバー側でHTMLが正しくレンダリングされず、画面が崩れたり空白になったりします。
3. 権利者・運営者による「アーカイブ削除依頼」の適用
著作権者やドメイン所有者が公式にアーカイブ削除依頼を提出し、受理されたドメインは、過去数十年分の履歴であっても一括して非公開化されます。
4. ドメインの失効とリダイレクトの混入
サイトが閉鎖された後にドメインが第三者に買い取られ(中古ドメイン)、全く別のスパムサイトや別サービスへ転送されている場合、カレンダー上に新しい無関係な履歴が上書きされて過去のデータが埋もれてしまう現象が起きます。
【裏技&応用編】URLが分からない消滅サイトの追跡法と開発者向け活用術
「昔よく見ていたサイトのドメイン名を忘れてしまった」「特定の階層にあった個別記事の正確なアドレスが分からない」という場合でも、諦める必要はありません。
ウェイバックマシンでは、URL入力欄にアスタリスク()を使ったワイルドカード検索が利用可能です。例えば、検索窓に「https://example.com/」と打ち込んで検索すると、そのドメイン配下で過去に保存されたすべてのサブページ一覧(URLプレフィックスリスト)が抽出されます。
この画面では、MIMEタイプ(html、jpg、pdfなど)やHTTPステータスコードでフィルタリングが可能なため、消失したPDF資料や特定の画像ファイルだけをピンポイントで発掘する強力な武器になります。
さらに、検索エンジン大手のキャッシュ機能が縮小傾向にある中、エンジニアやマーケターの間ではCDX APIを活用して、自社サイトのリンク切れ(404エラー)を過去ログへ自動リダイレクトさせる仕組みを構築するなど、高度なインフラ用途での活用も進んでいます。
【ウェイバックマシン】に関するよくある質問(FAQ)
Q1:ウェイバックマシンで過去のサイトを閲覧することは著作権法上、問題ありませんか?
A1:一般のユーザーが公開されている過去ログをブラウザ上で閲覧・私的利用する行為自体は、法的に何ら問題ありません。ただし、アーカイブから取得した他人の文章や画像を、無断で自身のWebサイトやSNSに再転載・再配布した場合は著作権侵害に該当する可能性があるため注意が必要です。
Q2:自分が運営しているサイトの過去ログを消したい場合、削除申請はできますか?
A2:可能です。インターネットアーカイブの公式窓口(info@archive.org)に対し、対象URL、ドメインの正当な所有者であることを証明する情報(WHOIS情報やドメイン認証用メールアドレス等)、削除を求める理由を明記して英語でメール連絡することで、除外措置を受けられます。
Q3:昔のページを開いても画像やCSSが読み込まれず、文字化けやレイアウト崩れが起きます。
A3:画像ファイルやスタイルシート(CSS)が外部サーバーに置かれていた場合、その外部ファイル自体がアーカイブされていないと表示崩れが発生します。また、別の保存日時(スナップショット)を選択すると画像が正常に保存されている場合もあるため、前後の日付を試行することをおすすめします。
まとめ:デジタル遺産を守り活用するための必須リテラシー
デジタルデータは半永久的に残ると思われがちですが、実際にはサーバーの契約終了やサイトの統合、方針転換によって、極めて脆く消滅しやすい性質を持っています。そうした中で、Webの歴史を保存し続けるウェイバックマシンの存在価値は計り知れません。
消えてしまった貴重な一次資料の調査から、失われたWeb資産の復元、さらには未来に向けた確実な情報保存まで、その正しい仕組みと使い方を理解しておくことは、情報収集を行うすべての人にとって強力なスキルとなるはずです。 (出典: ウェイ バック マシン(Yahoo!ニュース))


Webメディアの編集およびコンテンツ作成に従事。正確で質の高い情報発信を心掛けています。
